H1BScan
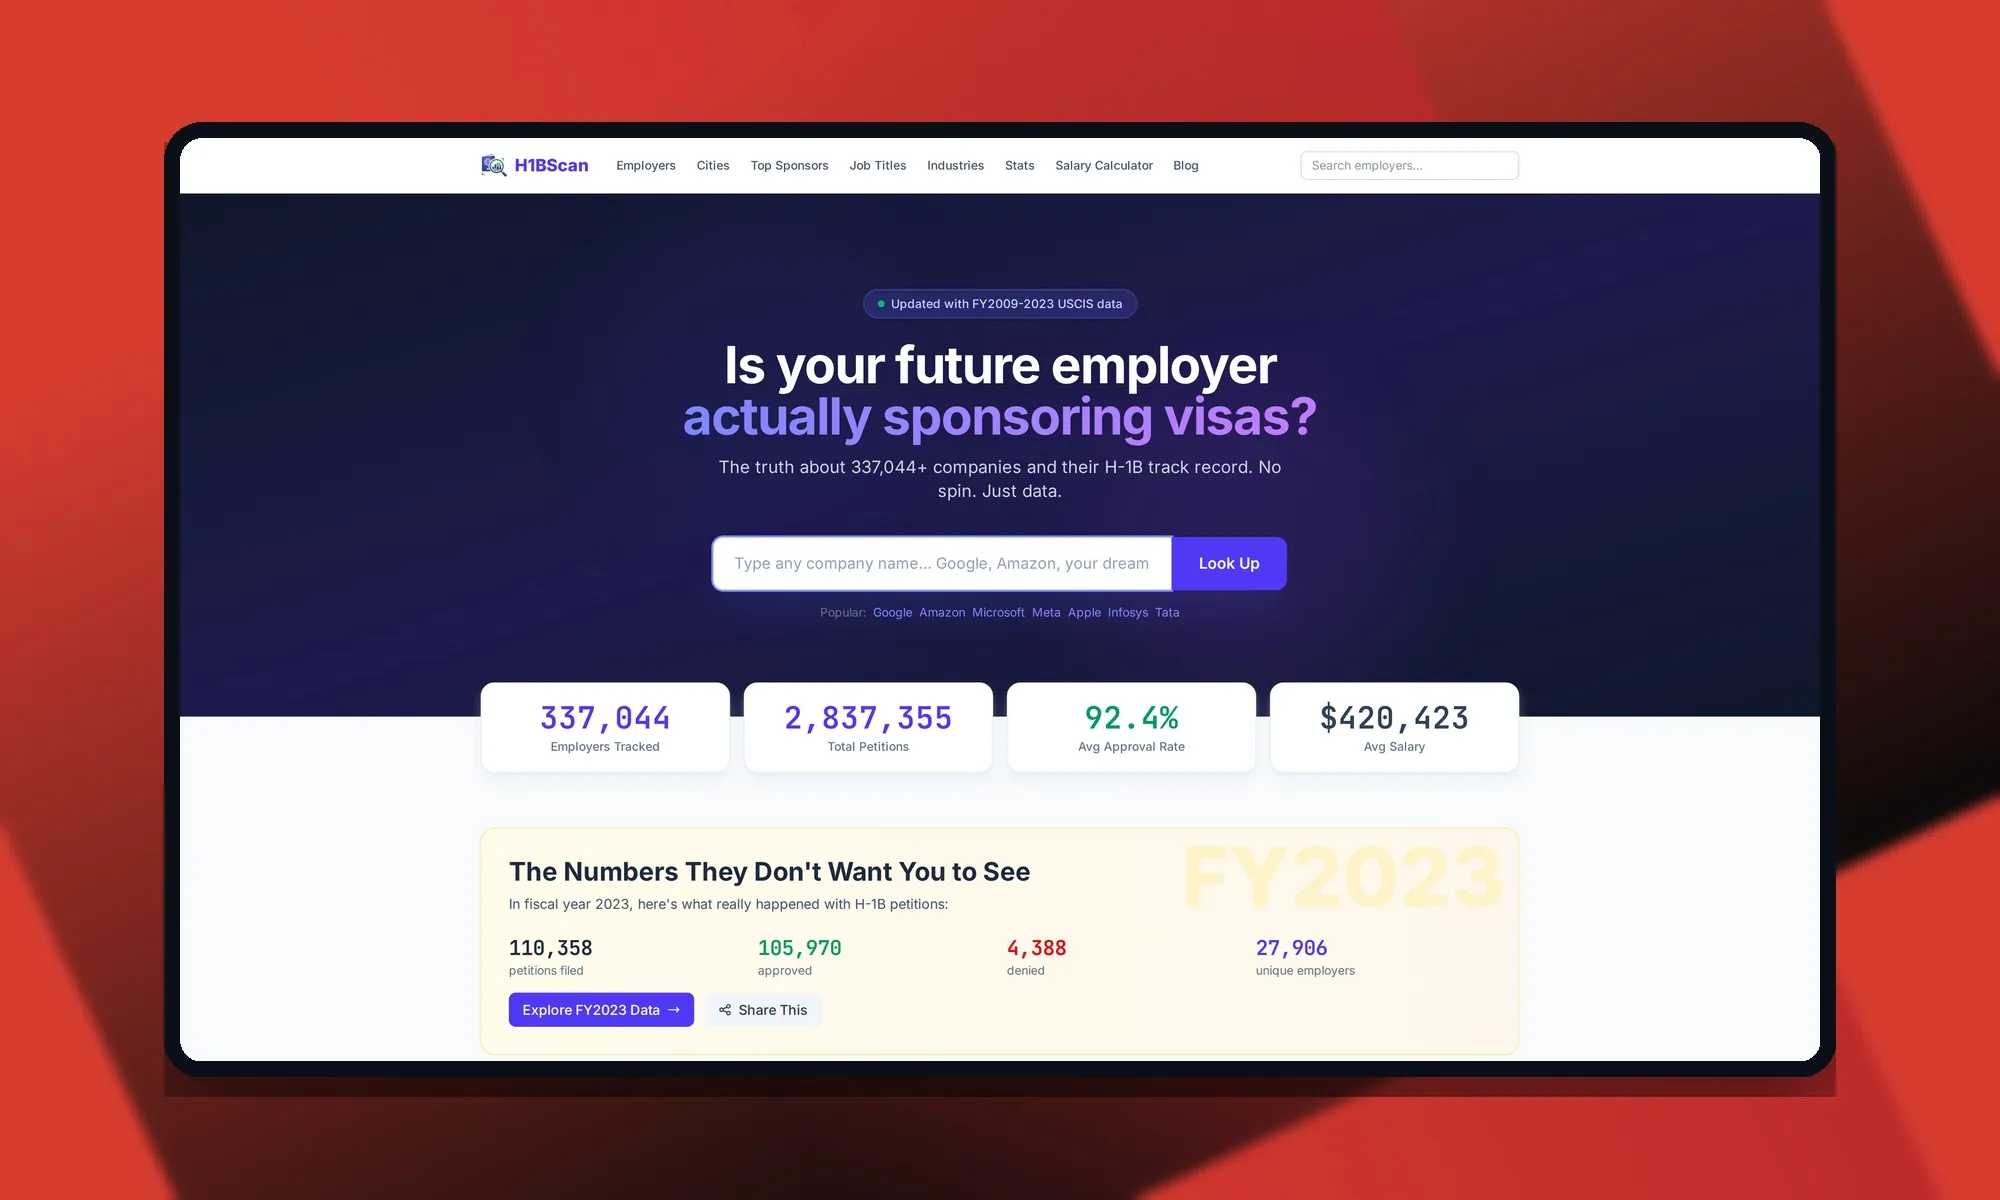
Utforskare av USA:s H-1B-visumdata som jag själv har designat, bygger och driver: ansökningshistorik, godkännandegrader och löner för 337 044 arbetsgivare, förvandlade till en sökmotor som vem som helst kan använda. Laravel + MySQL + programmatisk SEO.
Varför den finns: datan är offentlig, men ingen kan läsa den
För en utländsk ingenjör som förhandlar med ett amerikanskt företag är den avgörande frågan inte lönen: det är om företaget faktiskt hanterar H-1B-visum och med vilken framgång. Den informationen är offentlig — USCIS och arbetsmarknadsdepartementet publicerar den varje kvartal — men den kommer i råa filer med miljontals rader, omöjliga att slå i för en vanlig människa. Att satsa sin karriär på ett företag utan den uppgiften är att spela i blindo.
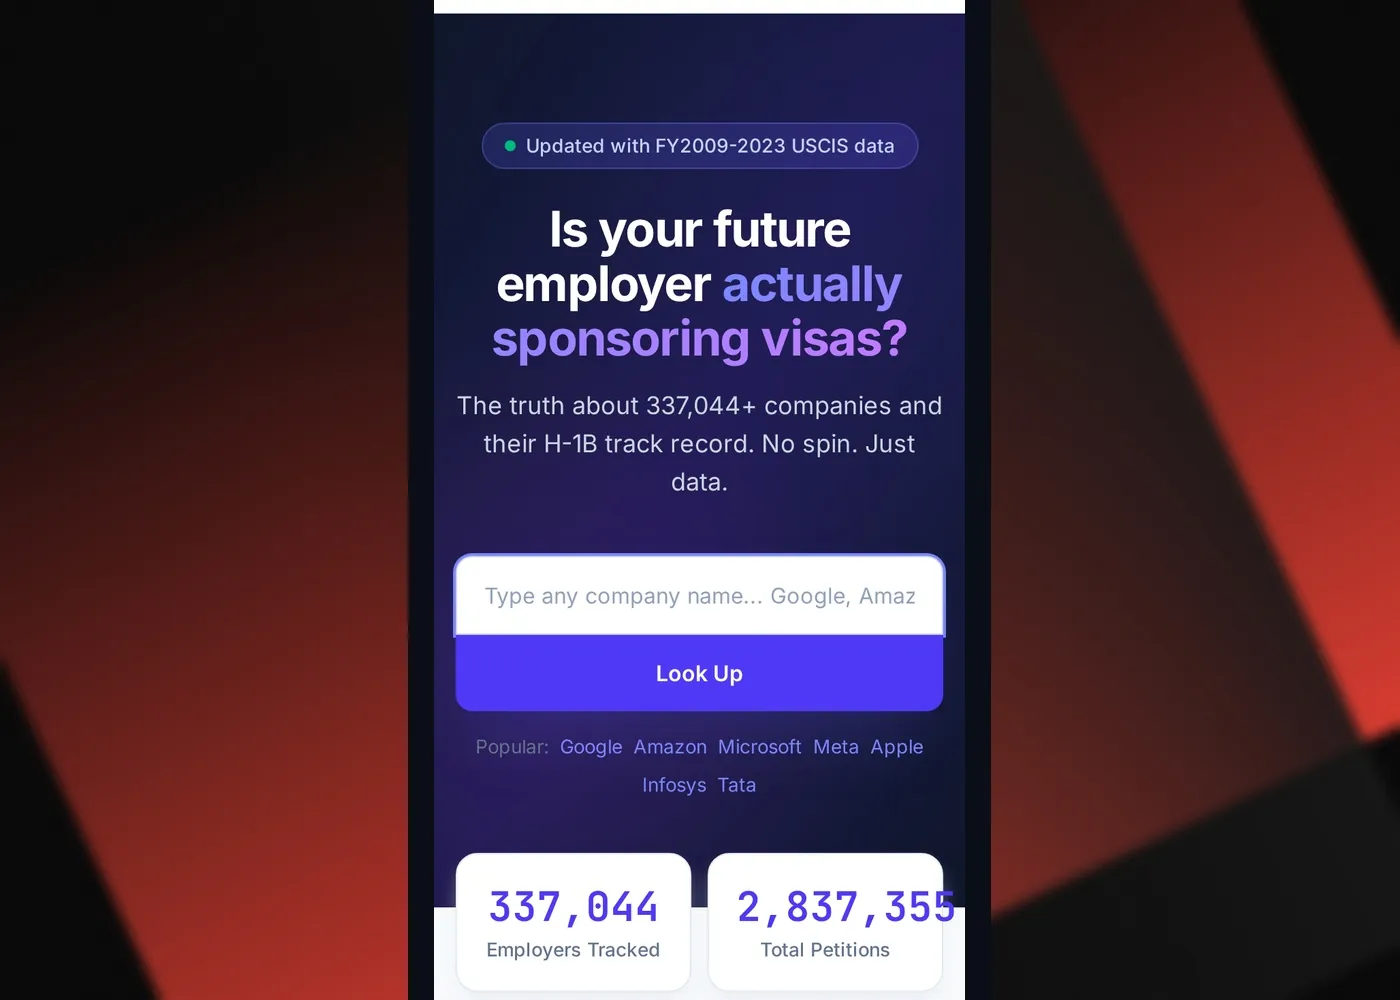
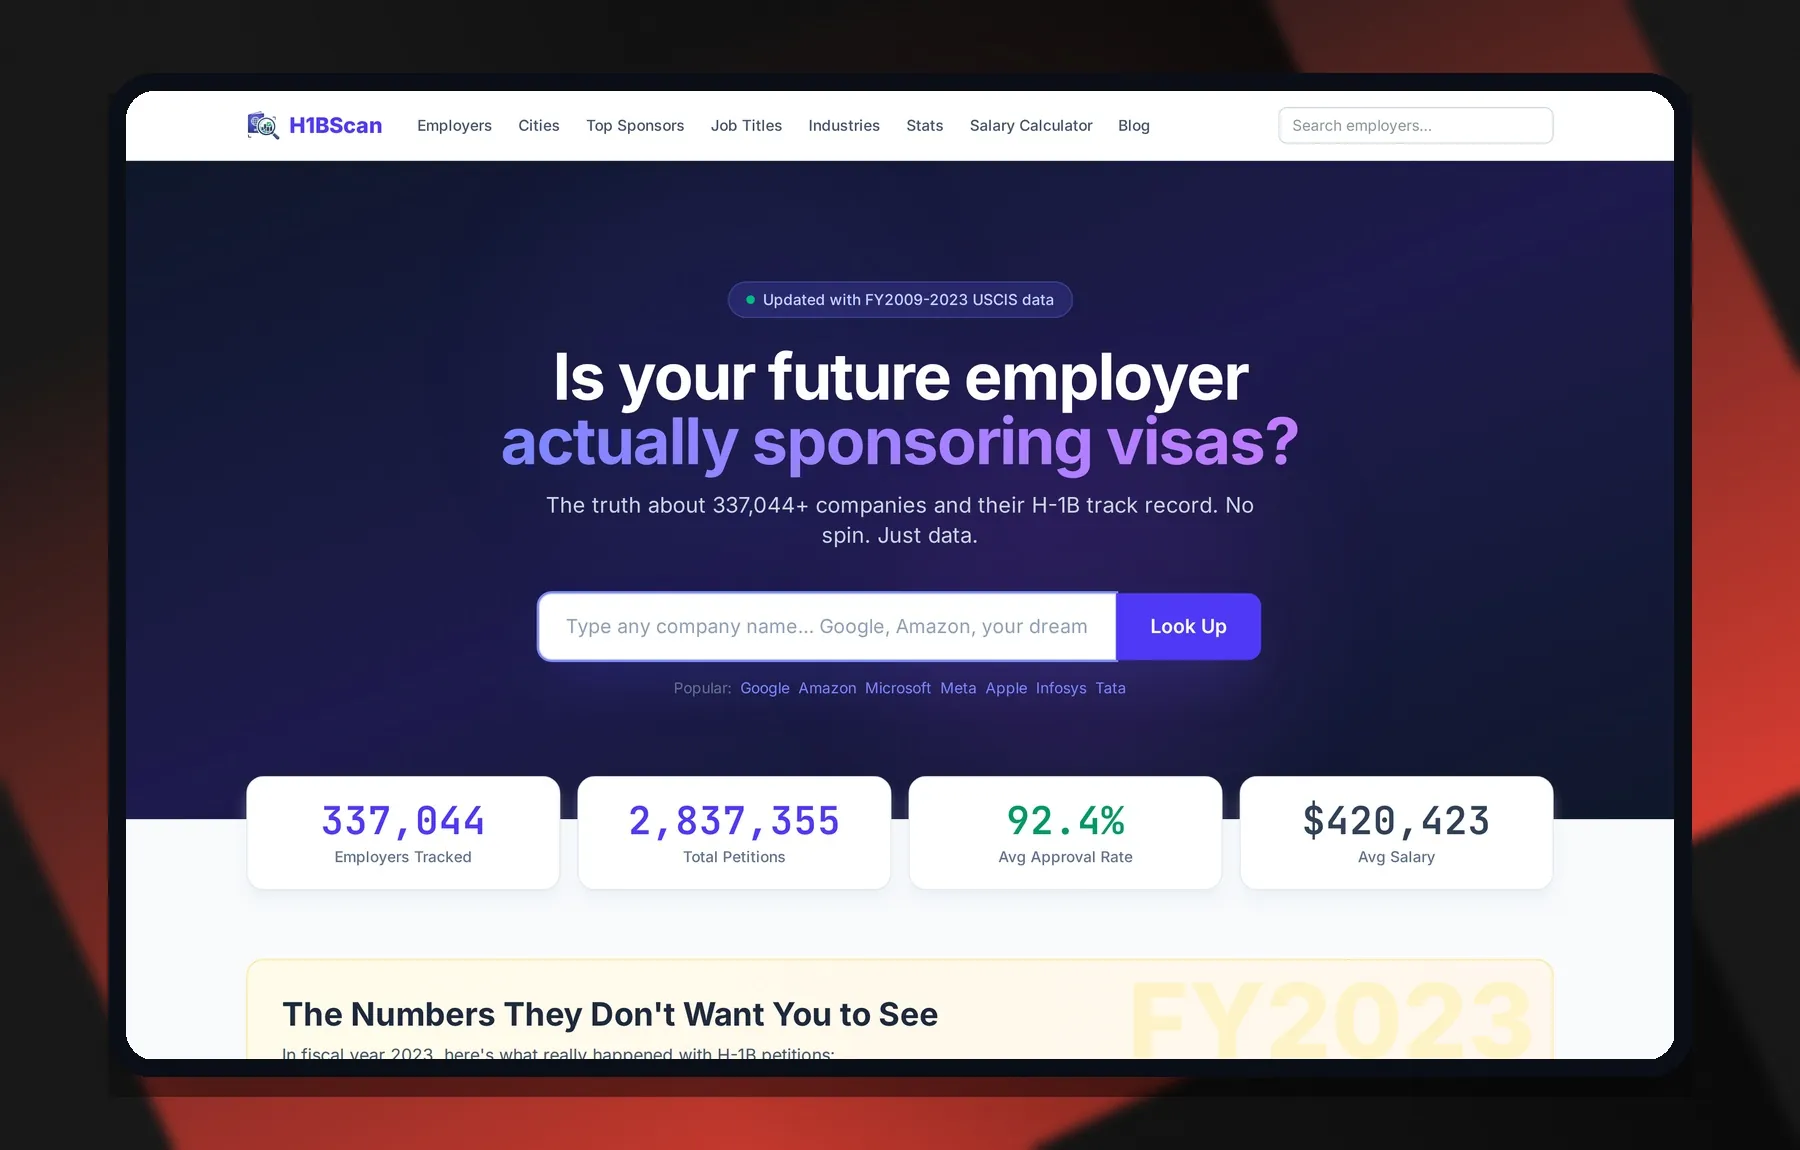
H1BScan.com är mitt svar på det problemet och ingår i mitt eget nätverk av webbplatser och verktyg: skriv företagets namn och se hela dess H-1B-historik — hur många ansökningar det lämnat in, hur många som godkänts, hur många som avslagits och vilka löner det angett. Utan registrering och utan finstilt.
Tonen är en del av produkten: ”utan utsmyckningar, bara data”. Startsidan visar utan omsvep hur många ansökningar som avslogs under det senaste räkenskapsåret, för att just den obekväma siffran är precis den användaren behöver innan hen bestämmer sig.
Vad man kan göra
- Profil per arbetsgivare med inlämnade, godkända och avslagna ansökningar, godkännandegrad och löner angivna i LCA:erna.
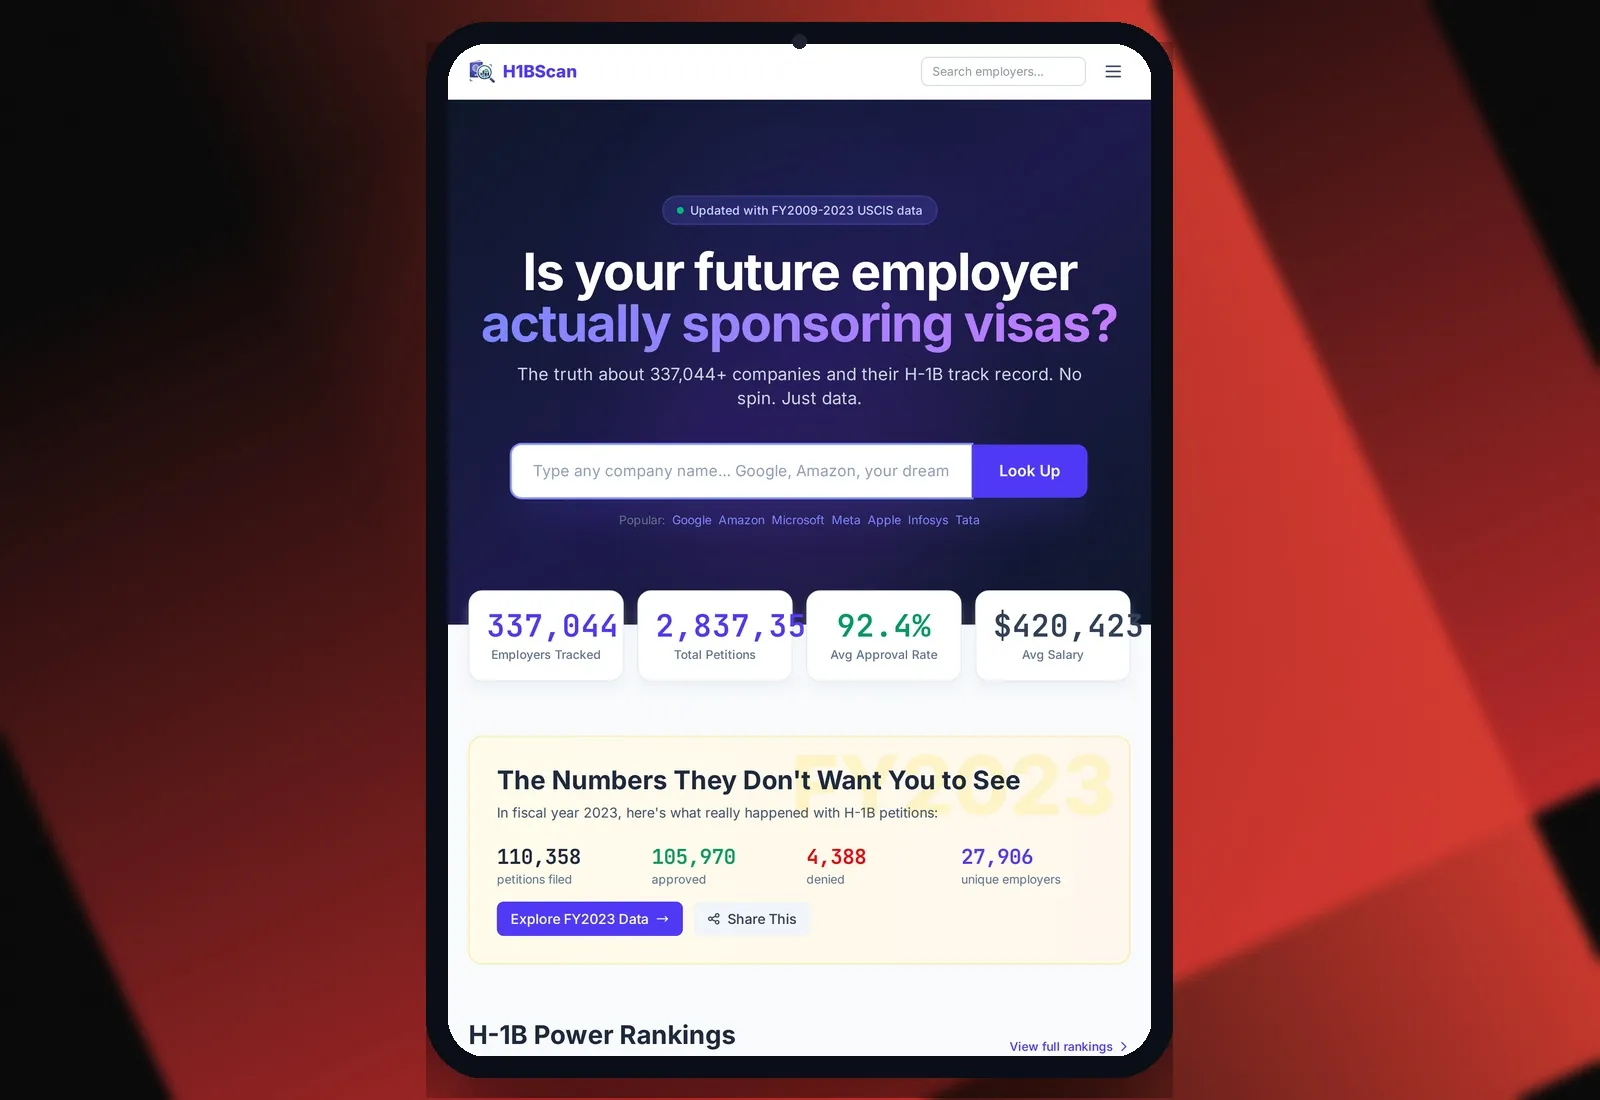
- Sponsorrankningar (”H-1B Power Rankings”): företagen som lämnar in flest ansökningar, med sin framgångsprocent bredvid.
- Utforskning per stad, befattning och bransch, plus en avdelning med aggregerad statistik per räkenskapsår.
- Lönekalkylator som bygger på LCA-data och på lönenivåerna I–IV i H-1B-systemet.
- Framhävd årssammanfattning: under FY2023 lämnades 110 358 ansökningar in, 105 970 godkändes och 4 388 avslogs bland 27 906 unika arbetsgivare.
- Blogg och FAQ som förklarar begrepp som LCA eller wage levels för den som börjar från noll.
Hur den är byggd
1. Laravel-arkitektur
- Laravel + PHP på MySQL: rena modeller och rutter för arbetsgivare, städer, befattningar, branscher och räkenskapsår, med Blade-mallar som delas av hundratusentals profilsidor.
- Frontend med Tailwind CSS och tillgångar kompilerade med Vite: CSS och JS versionerade per hash, utan tunga ramverk på klientsidan.
- Arbetsgivarsöket som nav i hela navigeringen: från startsidan, menyn och varje lista kan man hoppa till vilket företag som helst.
2. Datapipeline
- Kvartalsvis ETL: varje publicering från USCIS och DOL kommer in som råa filer som måste normaliseras, avdubbleras och stämmas av mot historiken — samma arbetsgivare dyker upp med tiotals olika stavningar över 15 räkenskapsår.
- Utan att bryta redan indexerade URL:er: varje datauppdatering förnyar siffror och aggregat medan arbetsgivarsluggarna som Google redan känner till hålls stabila.
- Förberäknade aggregat per räkenskapsår, stad, befattning och bransch, så att statistiksidorna inte räknar om miljontals rader vid varje besök.
3. Programmatisk SEO
- Varje arbetsgivare är en sida, och korsningarna per stad, befattning och bransch mångfaldigar de navigerbara och indexerbara vyerna utan manuellt arbete.
- Titel, metabeskrivning och strukturerad data genereras för varje vy: Organization- och FAQPage-schemana syns i källkoden på den skarpa webbplatsen.
- Systematisk intern länkning mellan profiler, rankningar och listor för att sprida auktoritet och se till att ingen sida blir föräldralös.
4. Prestanda
- MySQL-index och frågor designade så att en sökning bland 337 000 arbetsgivare svarar direkt.
- Cloudflare framför som CDN och bot-sköld, med cache för statiska filer och skydd av de rutter som scrapers hamrar hårdast på.
- Mätning med Google Analytics 4 för att veta vilka arbetsgivare, städer och befattningar folk faktiskt söker efter och prioritera roadmappen utifrån data.
Täckning och datakällor
Vi talar om 337 044 arbetsgivare och 2 837 355 ansökningar som täcker räkenskapsåren 2009 till 2023. Allt kommer från två officiella källor: USCIS H-1B Employer Data Hub (ansökningar, godkännanden och avslag) och arbetsmarknadsdepartementets Labor Condition Applications (befattningar, löner och platser), med kvartalsvis uppdatering kopplad till båda myndigheternas officiella publiceringskalender.
Den osynliga delen — att importera, tvätta och stämma av officiella data kvartal efter kvartal utan att försämra det som redan publicerats — är det som skiljer en seriös dataplattform från en CSV-dump med sökruta.
Resultatet
H1BScan är med marginal det största datasetet bland mina produkter och visar att samma angreppssätt som jag använder i spanska nischer fungerar i amerikansk skala och med en volym två storleksordningar större. Det är en levande produkt som jag själv driver: varje kvartal kommer nya data in, aggregaten räknas om och profilsidorna fortsätter svara direkt.
Som skyltfönster är läsningen enkel: om din verksamhet hänger på att göra en enorm katalog sökbar — produkter, ärenden, register, prislistor — är det här den typ av arkitektur som klarar det utan att svettas.
Några skärmbilder
Stack
Du kan testa med vilket känt företag som helst: besök h1bscan.com.
Frågor om H1BScan
Vilka datakällor matar H1BScan?
Två officiella amerikanska källor: USCIS H-1B Employer Data Hub (räkenskapsåren 2009–2023) och Labor Condition Applications (LCA) från arbetsmarknadsdepartementet. Enligt webbplatsen själv uppdateras båda kvartalsvis enligt den officiella publiceringskalendern.
Hur många företag och ansökningar samlar plattformen?
Startsidan visar 337 044 bevakade arbetsgivare och 2 837 355 ackumulerade H-1B-ansökningar, med en genomsnittlig godkännandegrad på 92,4%.
Vad kan en kandidat kontrollera innan hen tackar ja till ett jobberbjudande?
Företagets hela H-1B-historik: hur många ansökningar det lämnat in, hur många som godkänts eller avslagits, vilka löner det angett i sina LCA:er, i vilka roller och städer, och hur det står sig mot andra sponsorer i rankningarna.
Vad är en LCA och varför spelar den roll?
Labor Condition Application är det dokument arbetsgivaren lämnar in till arbetsmarknadsdepartementet innan hen ansöker om ett H-1B. Det innehåller befattning, erbjuden lön och plats, vilket gör det till den källa som ger processen verklig lönetransparens.
Vad är lönenivåerna (wage levels) I–IV i H-1B-systemet?
De motsvarar percentilen för den rådande lönen för rollen: nivå I (17:e percentilen) är ingångsnivå, nivå II (34) kvalificerad, nivå III (50) erfaren och nivå IV (67) fullt kompetent. H1BScans lönekalkylator bygger på dessa nivåer och på LCA-data.
Andra egna produkter
Behöver du något i den här storleksklassen?
Dataplattformar, programmatisk SEO och arkitekturer som klarar miljontals poster. Förutsättningslöst samtal på 30 minuter.
Begär gratis offert