H1BScan
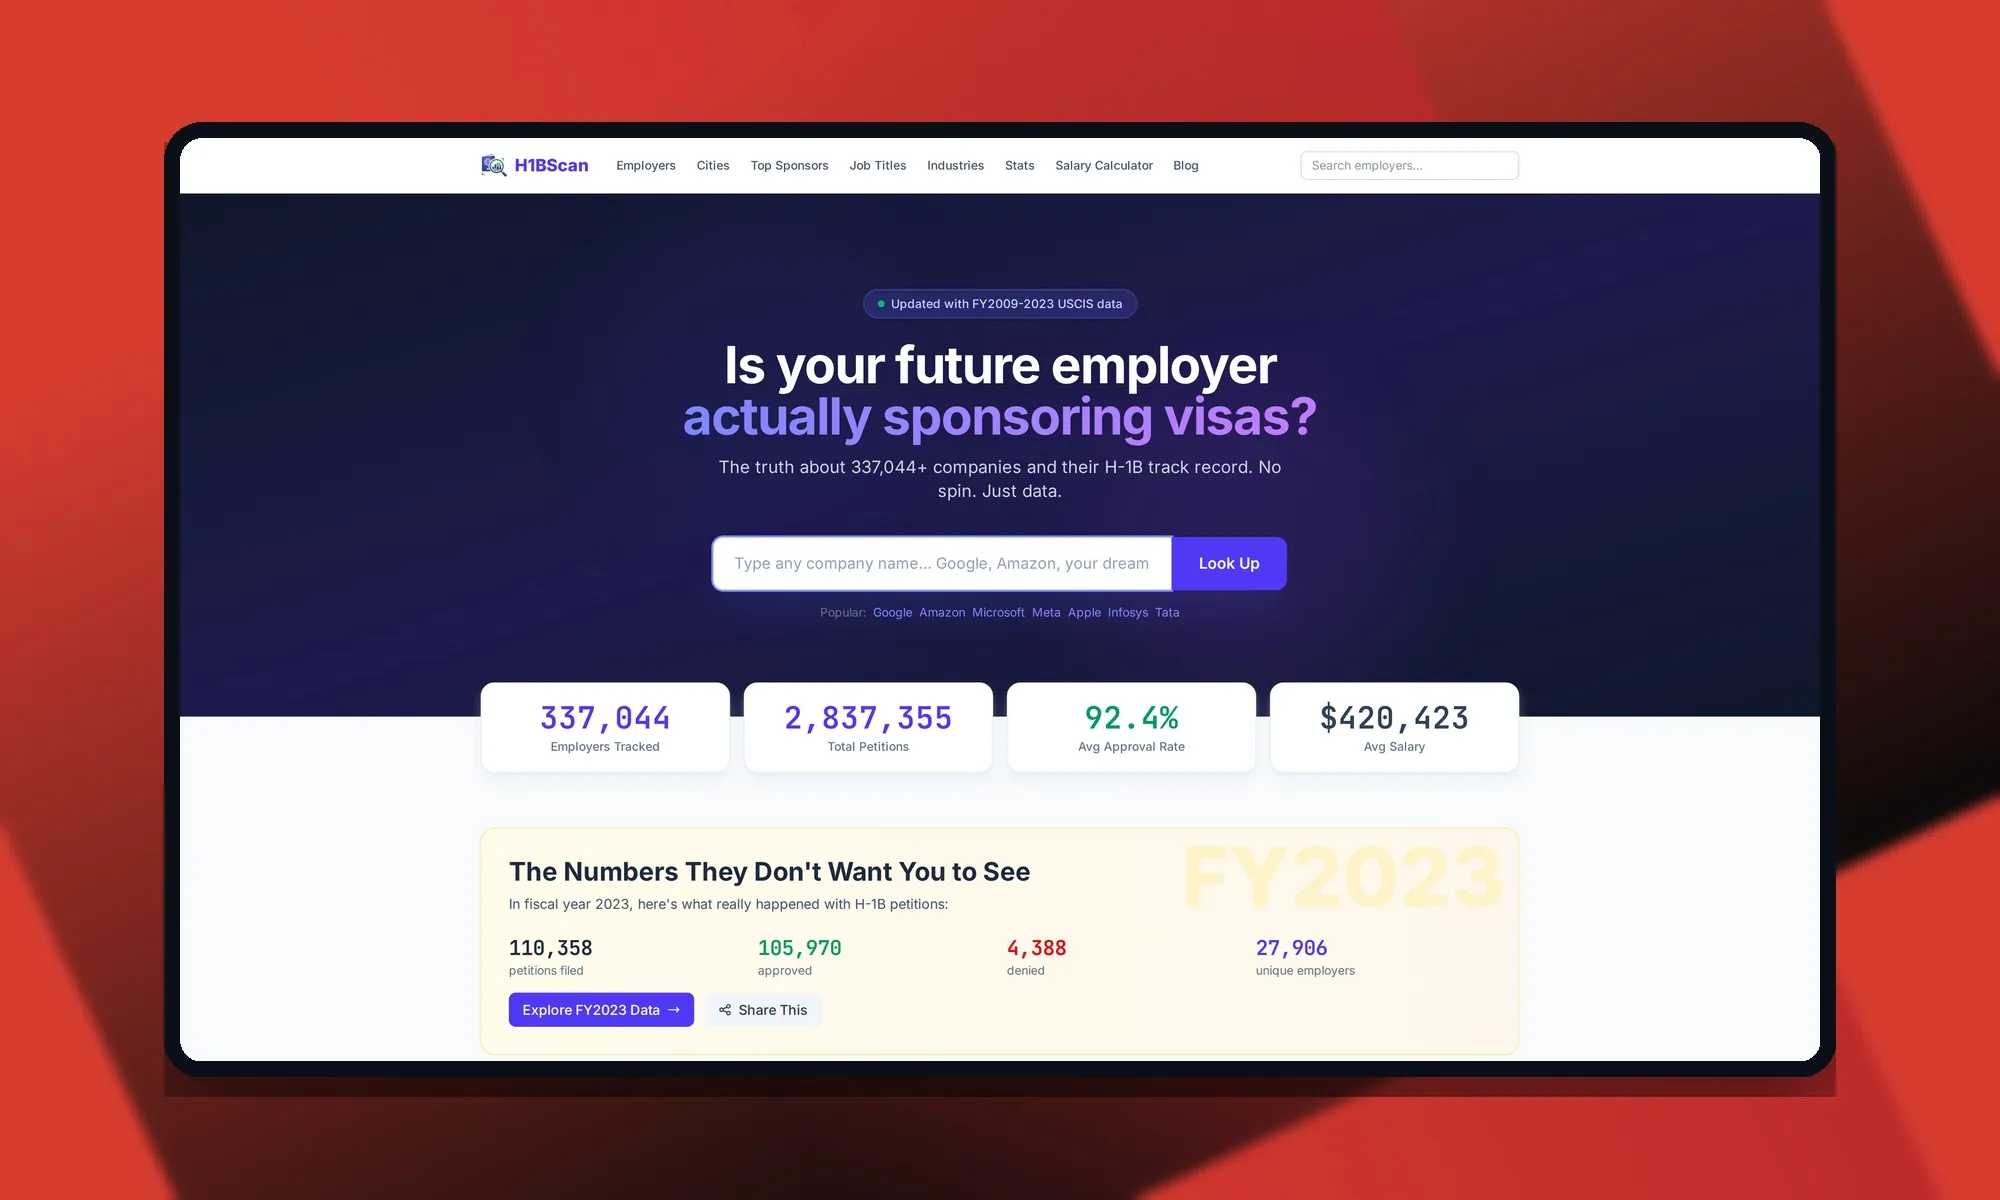
Un explorateur de données des visas H-1B américains que j'ai conçu, que je construis et que j'opère : l'historique des demandes, les taux d'approbation et les salaires de 337 044 employeurs, transformés en moteur de recherche accessible à tous. Laravel + MySQL + SEO programmatique.
Pourquoi il existe : les données sont publiques, mais personne ne peut les lire
Pour un ingénieur étranger qui négocie avec une entreprise américaine, la question décisive n'est pas le salaire : c'est de savoir si cette entreprise dépose vraiment des demandes de visa H-1B, et avec quel succès. Cette information est publique — l'USCIS et le département du Travail la publient chaque trimestre — mais elle arrive sous forme de fichiers bruts de plusieurs millions de lignes, impossibles à consulter pour une personne normale. Miser sa carrière sur une entreprise sans cette donnée, c'est jouer à l'aveugle.
H1BScan.com est ma réponse à ce problème, et il fait partie de mon propre réseau de sites et d'outils : vous saisissez le nom de l'entreprise et vous voyez son historique H-1B complet — combien de demandes elle a déposées, combien ont été approuvées, combien ont été refusées et quels salaires elle a déclarés. Sans inscription et sans petites lignes.
Le ton éditorial fait partie du produit : « sans fioritures, rien que des données ». La page d'accueil montre sans détour combien de demandes ont été refusées lors du dernier exercice fiscal, parce que cette donnée dérangeante est exactement celle dont l'utilisateur a besoin avant de décider.
Ce qu'il permet de faire
- Fiche par employeur avec les demandes déposées, approuvées et refusées, le taux d'approbation et les salaires déclarés dans les LCA.
- Classements de sponsors (« H-1B Power Rankings ») : les entreprises qui déposent le plus de demandes, avec leur pourcentage de réussite à côté.
- Exploration par villes, postes et secteurs, en plus d'une section de statistiques agrégées par exercice fiscal.
- Calculateur salarial appuyé sur les données des LCA et sur les niveaux de salaire I à IV du système H-1B.
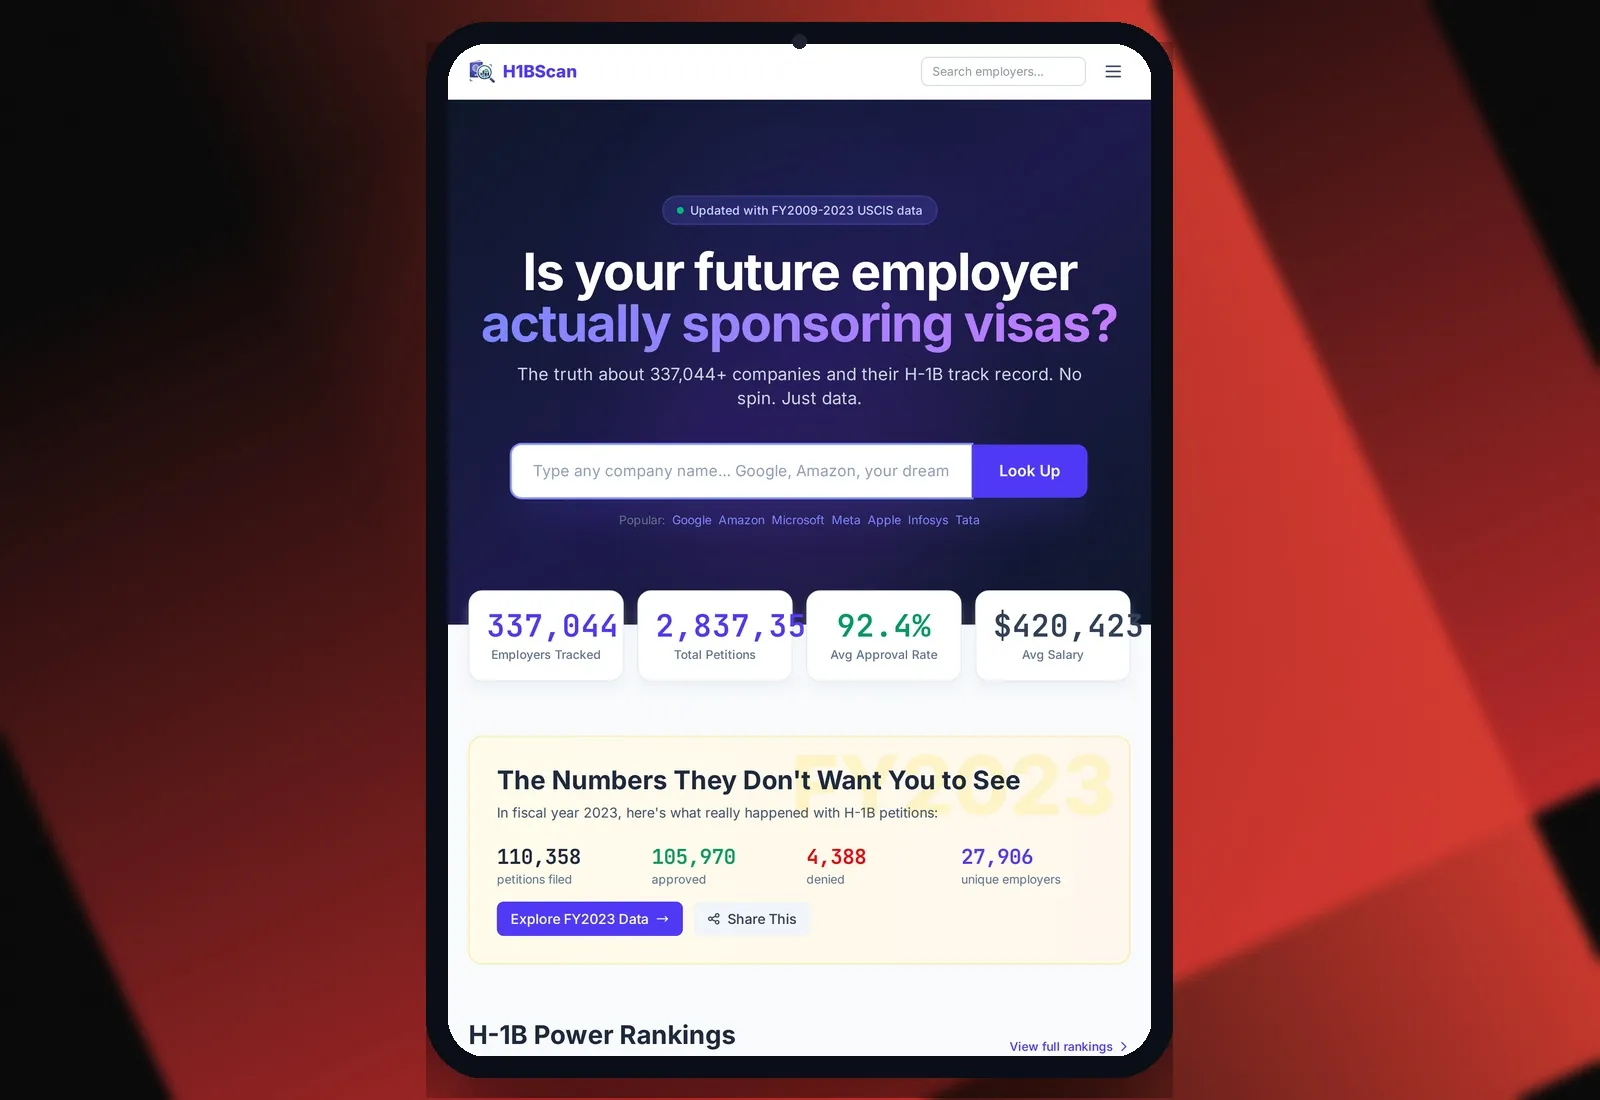
- Résumé annuel mis en avant : sur l'exercice 2023, 110 358 demandes ont été déposées, 105 970 approuvées et 4 388 refusées, pour 27 906 employeurs uniques.
- Blog et FAQ qui expliquent des notions comme la LCA ou les wage levels à qui part de zéro.
Comment c'est construit
1. Architecture Laravel
- Laravel + PHP sur MySQL : des modèles et des routes propres pour les employeurs, villes, postes, secteurs et exercices fiscaux, avec des templates Blade partagés entre des centaines de milliers de fiches.
- Frontend en Tailwind CSS et assets compilés avec Vite : CSS et JS versionnés par hash, sans framework lourd côté client.
- Le moteur de recherche d'employeurs comme axe de toute la navigation : depuis l'accueil, le menu et chaque liste, on peut sauter vers n'importe quelle entreprise.
2. Pipeline de données
- ETL trimestriel : chaque publication de l'USCIS et du DOL arrive sous forme de fichiers bruts qu'il faut normaliser, dédoublonner et réconcilier avec l'historique — le même employeur apparaît sous des dizaines de graphies différentes sur 15 exercices fiscaux.
- Aucune URL déjà indexée cassée : chaque rafraîchissement met à jour chiffres et agrégats tout en gardant stables les slugs d'employeur que Google connaît déjà.
- Agrégats précalculés par exercice fiscal, ville, poste et secteur, pour que les pages de statistiques ne recalculent pas des millions de lignes à chaque visite.
3. SEO programmatique
- Chaque employeur est une page, et les croisements par ville, poste et secteur multiplient les vues navigables et indexables sans intervention manuelle.
- Titre, meta description et données structurées générés pour chaque vue : les schémas Organization et FAQPage sont visibles dans le code source du site en production.
- Maillage interne systématique entre fiches, classements et listes pour distribuer l'autorité et ne laisser aucune page orpheline.
4. Performances
- Index et requêtes MySQL conçus pour qu'une recherche parmi 337 000 employeurs réponde instantanément.
- Cloudflare en frontal comme CDN et bouclier anti-bots, avec cache des statiques et protection des routes les plus visées par les scrapers.
- Mesure avec Google Analytics 4 pour savoir quels employeurs, villes et postes les gens cherchent vraiment, et prioriser la roadmap avec des données.
Couverture et origine des données
On parle de 337 044 employeurs et 2 837 355 demandes couvrant les exercices fiscaux 2009 à 2023. Tout provient de deux sources officielles : le H-1B Employer Data Hub de l'USCIS (demandes, approbations et refus) et les Labor Condition Applications du département du Travail (postes, salaires et lieux de travail), avec une mise à jour trimestrielle calée sur le calendrier officiel de publication des deux agences.
Cette partie invisible — importer, nettoyer et réconcilier des données officielles trimestre après trimestre sans dégrader ce qui est déjà publié — est ce qui sépare une plateforme de données sérieuse d'un simple export CSV avec un moteur de recherche.
Le résultat
H1BScan est, de loin, le plus gros jeu de données de mes produits, et il démontre que l'approche que j'applique à des niches espagnoles fonctionne à l'échelle américaine, avec un volume deux ordres de grandeur plus grand. C'est un produit vivant que j'opère moi-même : chaque trimestre, de nouvelles données arrivent, les agrégats sont recalculés et les fiches continuent de répondre instantanément.
Côté vitrine, la lecture est directe : si votre activité dépend de rendre consultable un catalogue énorme — produits, dossiers, registres, tarifs —, c'est ce type d'architecture qui tient la charge sans broncher.
Quelques captures d'écran
Stack
Vous pouvez le tester avec n'importe quelle entreprise connue : visiter h1bscan.com.
Questions sur H1BScan
Quelles sources de données alimentent H1BScan ?
Deux sources officielles américaines : le H-1B Employer Data Hub de l'USCIS (exercices fiscaux 2009-2023) et les Labor Condition Applications (LCA) du département du Travail. D'après le site lui-même, les deux sont rafraîchies chaque trimestre en suivant le calendrier officiel de publication.
Combien d'entreprises et de demandes la plateforme recense-t-elle ?
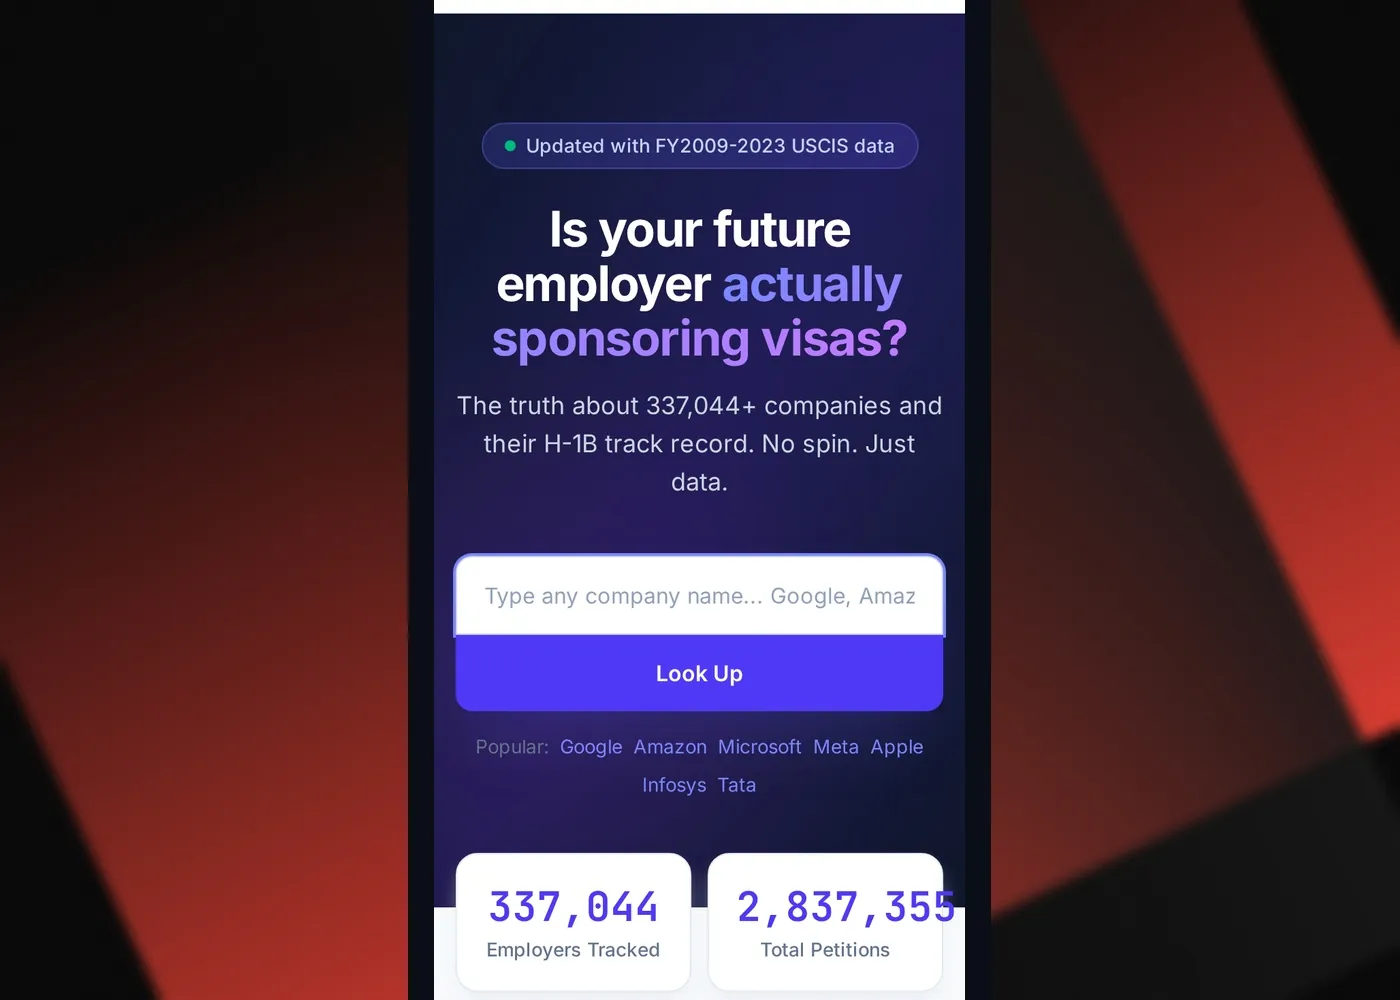
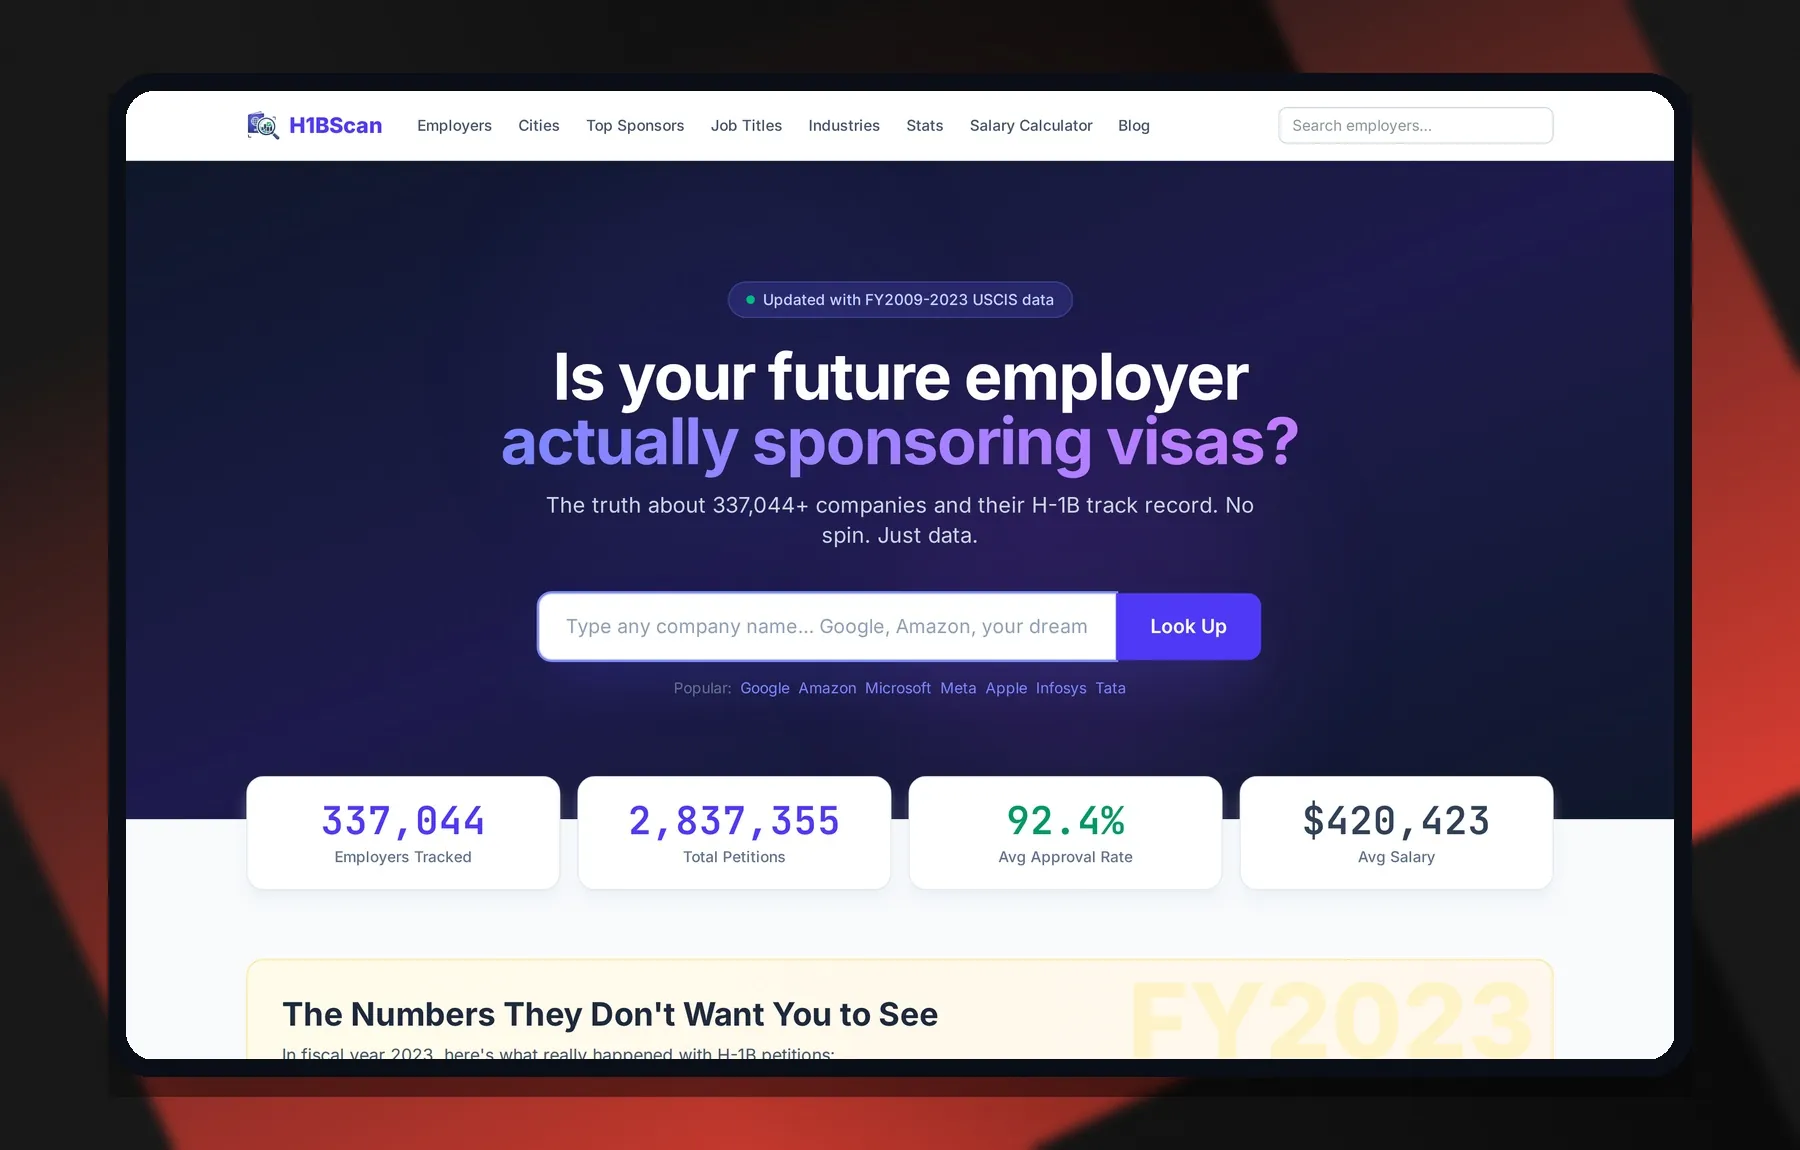
La page d'accueil affiche 337 044 employeurs suivis et 2 837 355 demandes H-1B cumulées, avec un taux d'approbation moyen de 92,4 %.
Que peut vérifier un candidat avant d'accepter une offre ?
L'historique complet des demandes H-1B de l'entreprise : combien elle en a déposées, combien ont été approuvées ou refusées, quels salaires elle a déclarés dans les LCA, sur quels postes et dans quelles villes, et comment elle se compare aux autres sponsors dans les classements.
Qu'est-ce qu'une LCA et pourquoi est-ce important ?
La Labor Condition Application est le document que l'employeur dépose auprès du département du Travail avant de demander un H-1B. Elle indique le poste, le salaire proposé et le lieu de travail : c'est donc la source qui apporte une vraie transparence salariale au processus.
Que sont les niveaux de salaire (wage levels) I à IV du H-1B ?
Ils correspondent au percentile du salaire en vigueur pour le poste : le niveau I (17e percentile) est un profil débutant, le II (34e) qualifié, le III (50e) expérimenté et le IV (67e) pleinement compétent. Le calculateur salarial de H1BScan s'appuie sur ces niveaux et sur les données des LCA.
D'autres produits maison
Besoin de quelque chose de cette envergure ?
Plateformes de données, SEO programmatique et architectures qui encaissent des millions d'enregistrements. Appel de 30 minutes sans engagement.
Demander un devis gratuit