RecallDex
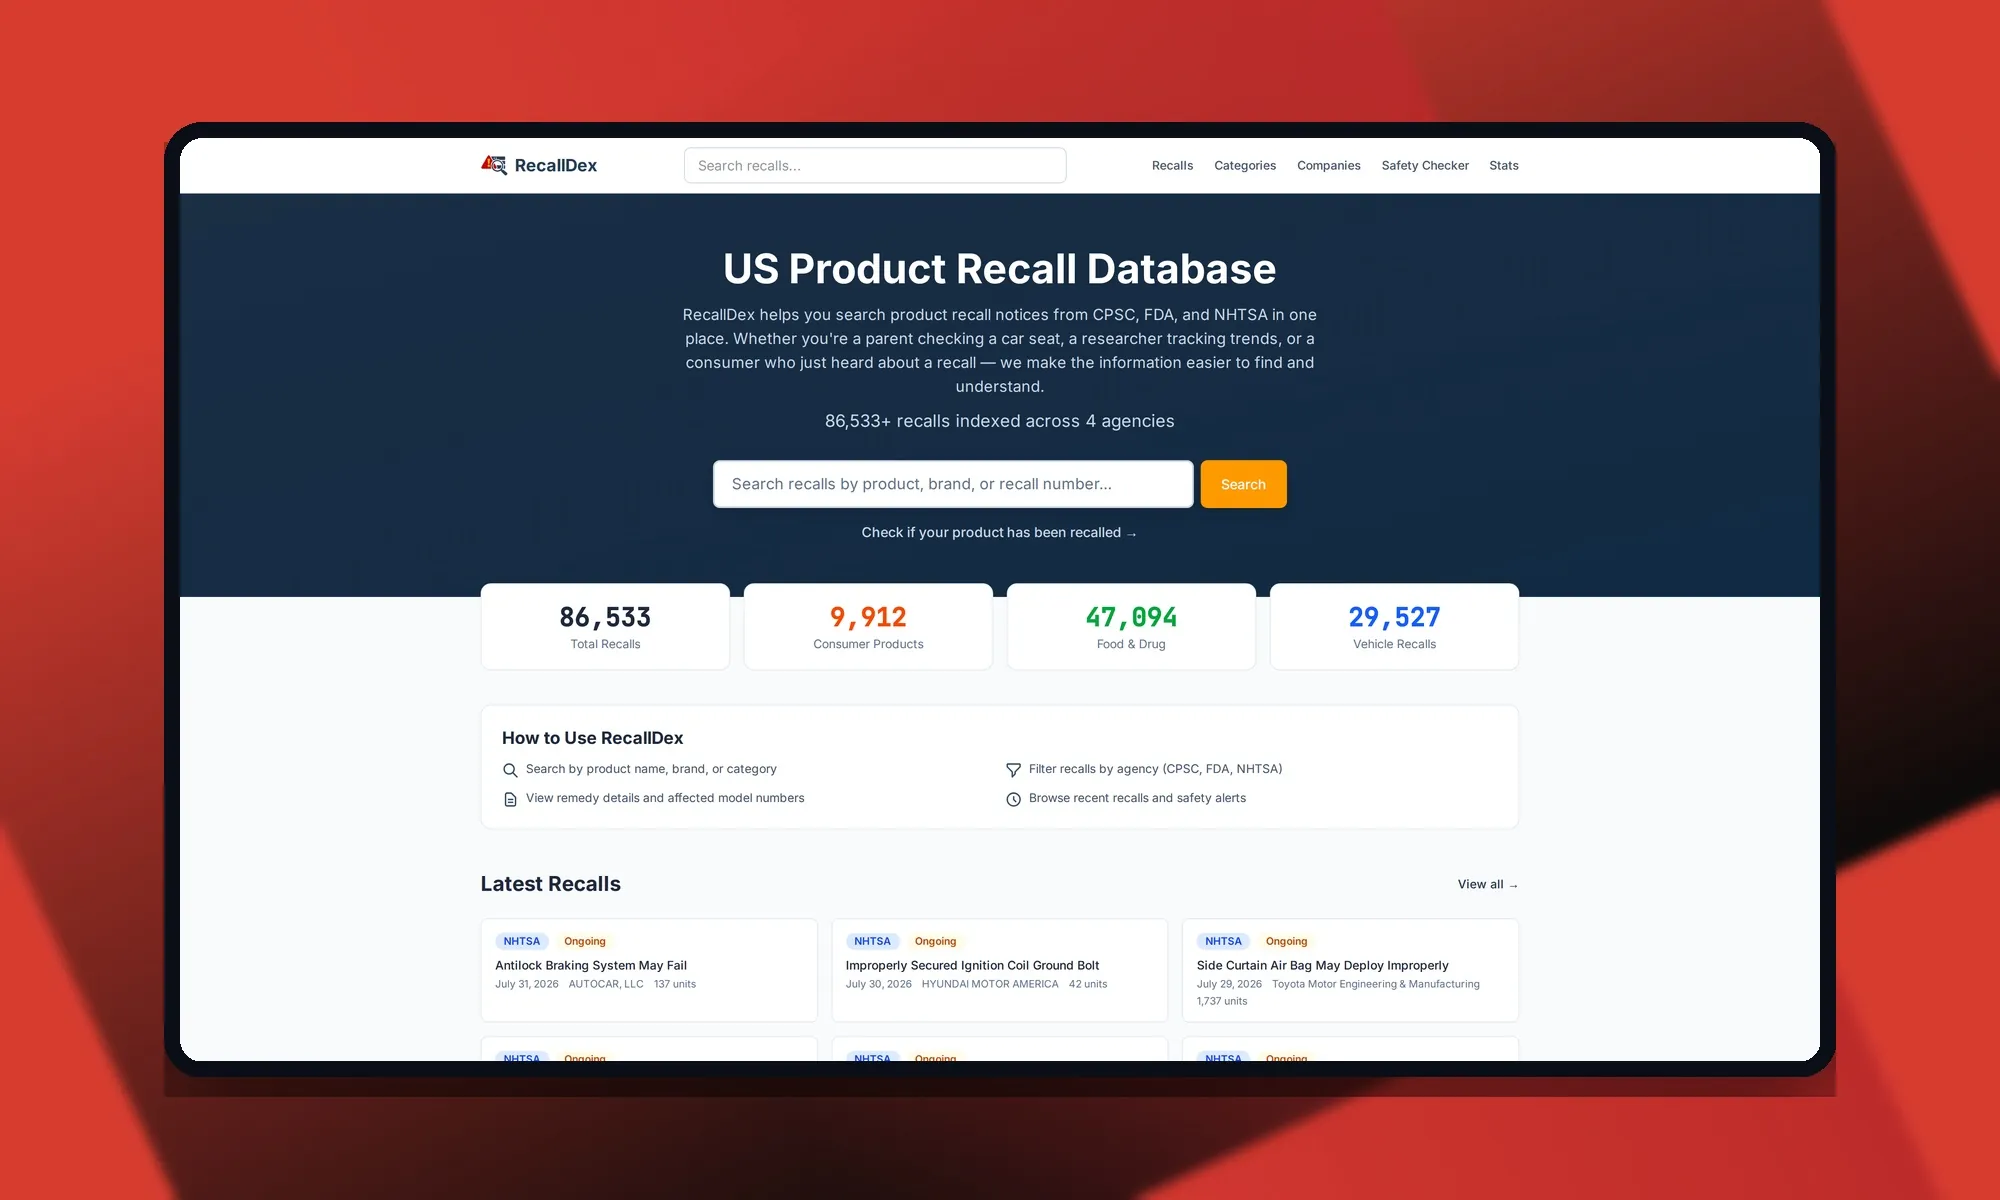
Mais de 86.500 recolhas oficiais de brinquedos, alimentos, medicamentos e veículos nos EUA, reunidas num único motor de busca com verificador de segurança. Um produto próprio da minha rede de sites: conceito, desenvolvimento, pipeline de dados e SEO, tudo de lavra própria.
Porque existe: quatro agências, zero visão de conjunto
Nos Estados Unidos, as recolhas de produto não são publicadas num único sítio. A CPSC anuncia as de produtos de consumo, a FDA as de alimentos por um lado e as de medicamentos por outro, e a NHTSA as de veículos. Quatro bases de dados com formatos diferentes, motores de busca diferentes e critérios diferentes. Quem quer saber se a sua cadeira auto, o seu medicamento ou a sua carrinha estão afetados tem primeiro de saber a que agência perguntar — e a maioria das pessoas não sabe.
O RecallDex existe para eliminar esse problema: agrega os avisos das quatro fontes oficiais, normaliza-os num esquema único e torna-os pesquisáveis a partir de uma só caixa de pesquisa. Hoje indexa 86.533 recolhas e continua a crescer com cada novo aviso.
É um produto próprio da minha rede de sites de dados públicos: concebi-o, construí-o e opero-o eu, de princípio a fim.
O que permite fazer
- Pesquisar recolhas por nome de produto, marca ou número de recall.
- Filtrar por agência: CPSC, FDA (alimentos), FDA (medicamentos) ou NHTSA.
- Safety Checker: confirmar em segundos se um produto concreto foi recolhido.
- Ver a solução e os modelos afetados de cada recolha, com unidades implicadas e fabricante.
- Navegar por categorias (veículos, alimentação, fármacos, berços, brinquedos, bicicletas…), cada uma com o seu contador real de processos.
- Consultar o diretório de empresas ordenado por número de recolhas acumuladas.
- Acompanhar os últimos alertas publicados, com a data, a empresa, as unidades afetadas e o estado (em curso ou encerrada).
Como está construído
1. Arquitetura Laravel
- Laravel + PHP no backend com Alpine.js como camada de interatividade leve — sem SPA, sem peso desnecessário.
- MySQL normalizado: recolhas, categorias, empresas e fontes em tabelas relacionadas, de modo que qualquer entidade resolve num URL próprio.
- Rotas semânticas: cada recolha vive num slug legível que inclui o número de processo oficial, e cada categoria e empresa tem o seu hub navegável.
2. Pipeline de dados
- ETL contra quatro fontes oficiais com formatos díspares, unificadas num esquema único e coerente.
- Normalização de fabricantes, categorias, estados do processo e unidades afetadas para que tudo seja filtrável e comparável.
- Incorporação periódica de novos avisos: a página inicial mostra recolhas publicadas na própria semana, com o estado atualizado.
3. SEO programático
- Dezenas de milhares de fichas indexáveis, cada uma com title, meta description e dados estruturados próprios gerados a partir da base de dados.
- Hubs por agência, categoria e empresa que distribuem autoridade interna para as fichas de recolha e captam long tail.
- Desenvolvimento à medida, sem templates nem plugins: o HTML sai do servidor pronto a indexar.
4. Desempenho
- Renderização no servidor: o conteúdo chega completo na primeira resposta, sem esperar pelo JavaScript.
- Consultas indexadas e paginação para servir catálogos de dezenas de milhares de registos sem degradar os tempos.
- Assets compilados e versionados com Vite, com pré-carregamento do CSS e JS críticos.
Cobertura e origem dos dados
Os dados provêm exclusivamente de registos públicos oficiais dos EUA: a CPSC contribui com 9.912 recolhas de produtos de consumo, a FDA soma 29.263 de alimentos e 17.831 de medicamentos, e a NHTSA acrescenta 29.527 de veículos.
A escala dos processos varia enormemente: entre os últimos alertas convivem campanhas de um punhado de unidades e outras massivas, como um recall da Mercedes-Benz por risco de deslocação do veículo com mais de 310.000 veículos afetados. No ranking de empresas, a Ford encabeça a lista com 1.691 processos, seguida da General Motors com 1.183.
O resultado
O RecallDex funciona ao mesmo tempo como serviço real para consumidores e como demonstração pública do que sei construir: um ETL a sério sobre quatro fontes com formatos incompatíveis, um verificador que responde em segundos consultando mais de 86.000 recolhas e uma superfície de dezenas de milhares de páginas indexáveis que cresce sozinha com cada novo aviso das agências.
É exatamente o mesmo padrão que aplico em projetos de cliente: agregar, normalizar e publicar dados de qualquer setor em plataformas rápidas que posicionam sozinhas.
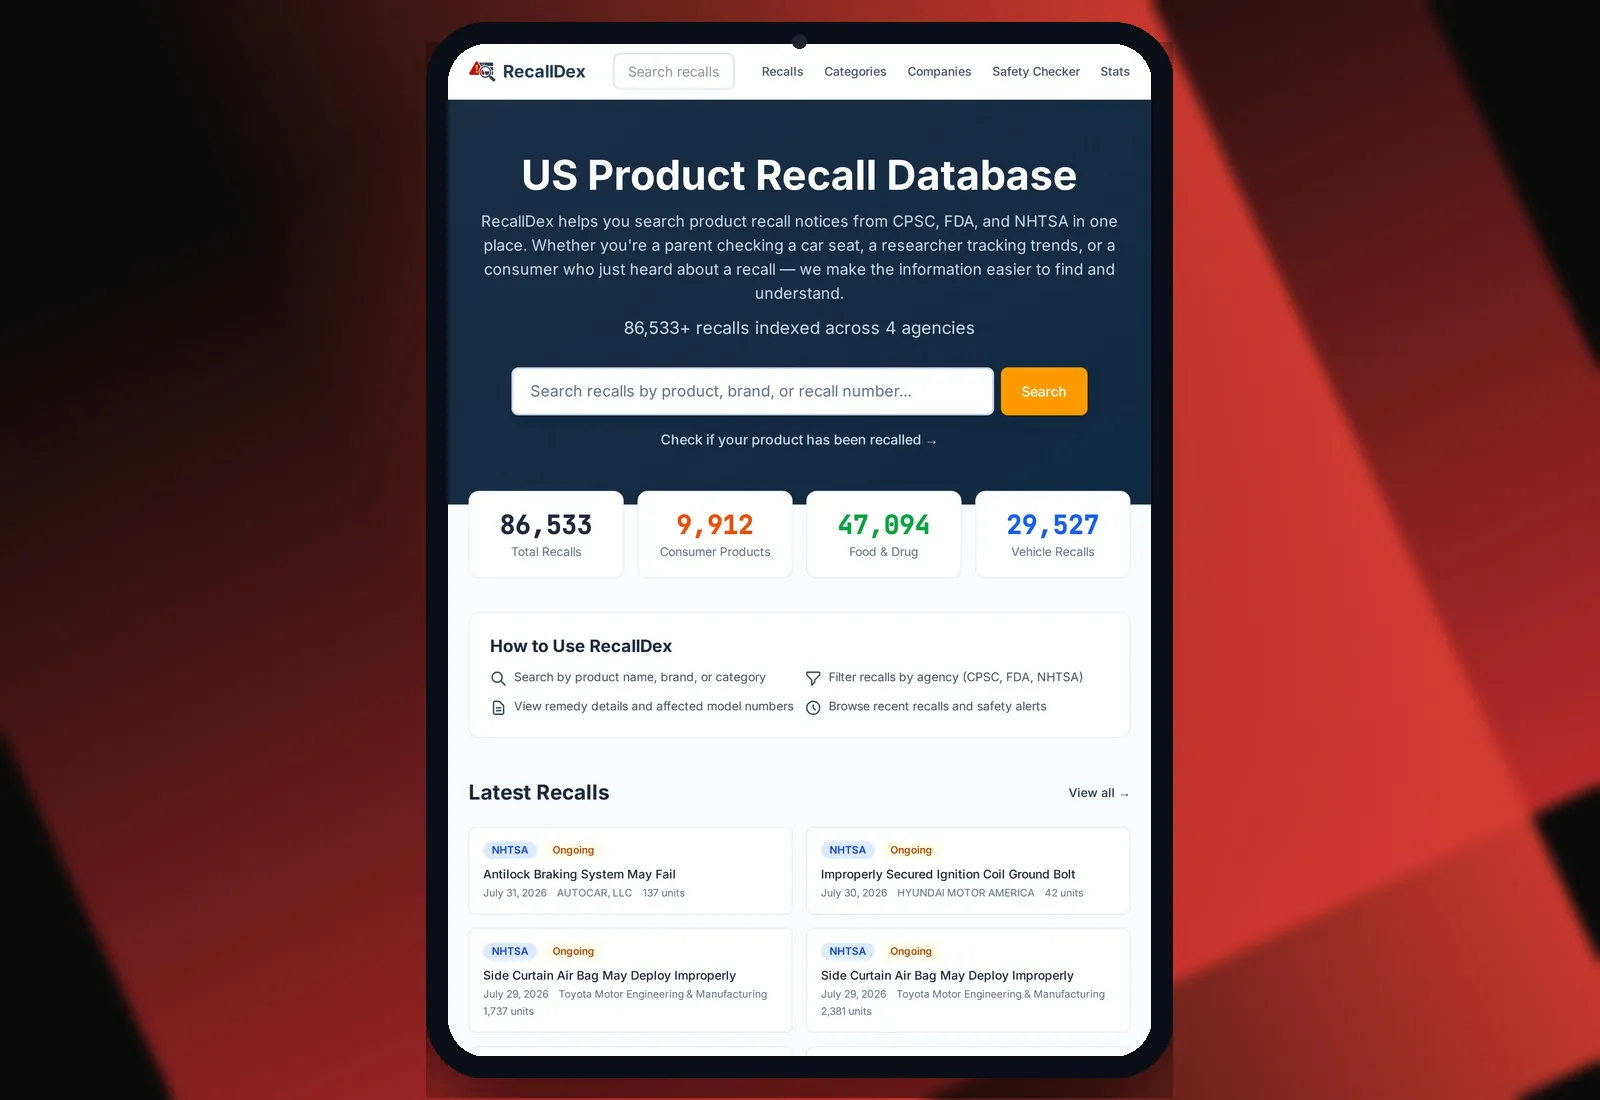
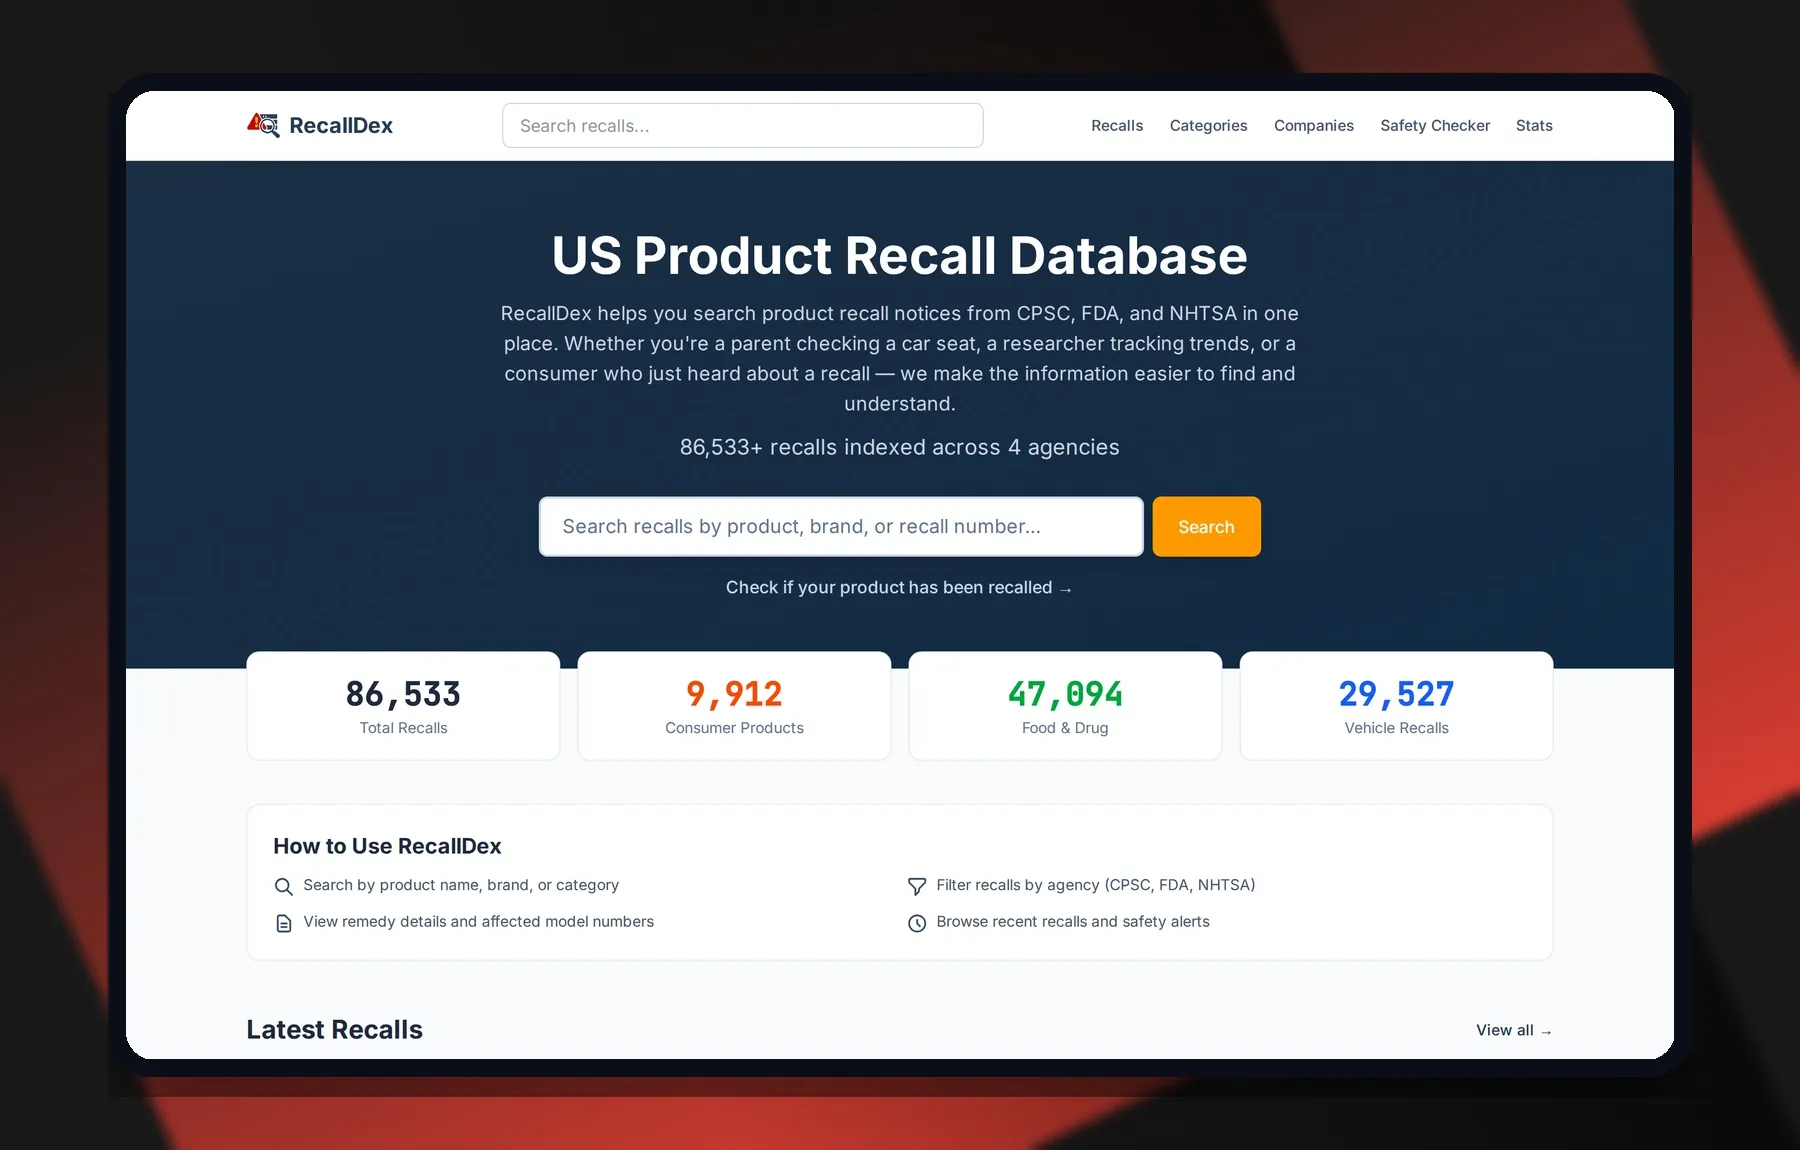
Algumas capturas
Stack
O produto, ao vivo: Visitar recalldex.com
Perguntas frequentes
Que organismos alimentam o RecallDex?
Quatro fontes oficiais dos EUA: a CPSC (produtos de consumo), a FDA nas suas duas vertentes de alimentos e medicamentos, e a NHTSA (veículos).
Quantas recolhas estão registadas?
Mais de 86.500 no total: cerca de 9.900 de produtos de consumo (CPSC), 47.000 de alimentação e fármacos (FDA) e 29.500 de veículos (NHTSA). O número cresce com cada novo aviso publicado pelas agências.
Como sei se um produto que tenho em casa está afetado?
Com o verificador de segurança (Safety Checker) pode confirmar se foi recolhido; cada ficha detalha ainda a solução oferecida e os números de modelo afetados.
A base de dados é atualizada?
Sim. Os novos avisos das agências são incorporados periodicamente: a página inicial mostra as últimas recolhas publicadas, com a data, a empresa responsável, as unidades afetadas e o estado do processo (em curso ou encerrado).
Que empresas acumulam mais recolhas?
O diretório de empresas ordena-as por número de processos: a Ford encabeça a lista com mais de 1.600 recalls, seguida da General Motors com mais de 1.100.
A quem é útil a plataforma?
A pais que verificam uma cadeira auto para criança, a investigadores que seguem tendências de segurança ou a qualquer consumidor que acabou de ouvir falar de uma recolha.
Outros produtos próprios
Precisa de uma plataforma de dados desta envergadura?
Laravel, ETL de fontes públicas e SEO programático à escala. Chamada de 30 minutos sem compromisso.
Pedir orçamento gratuito